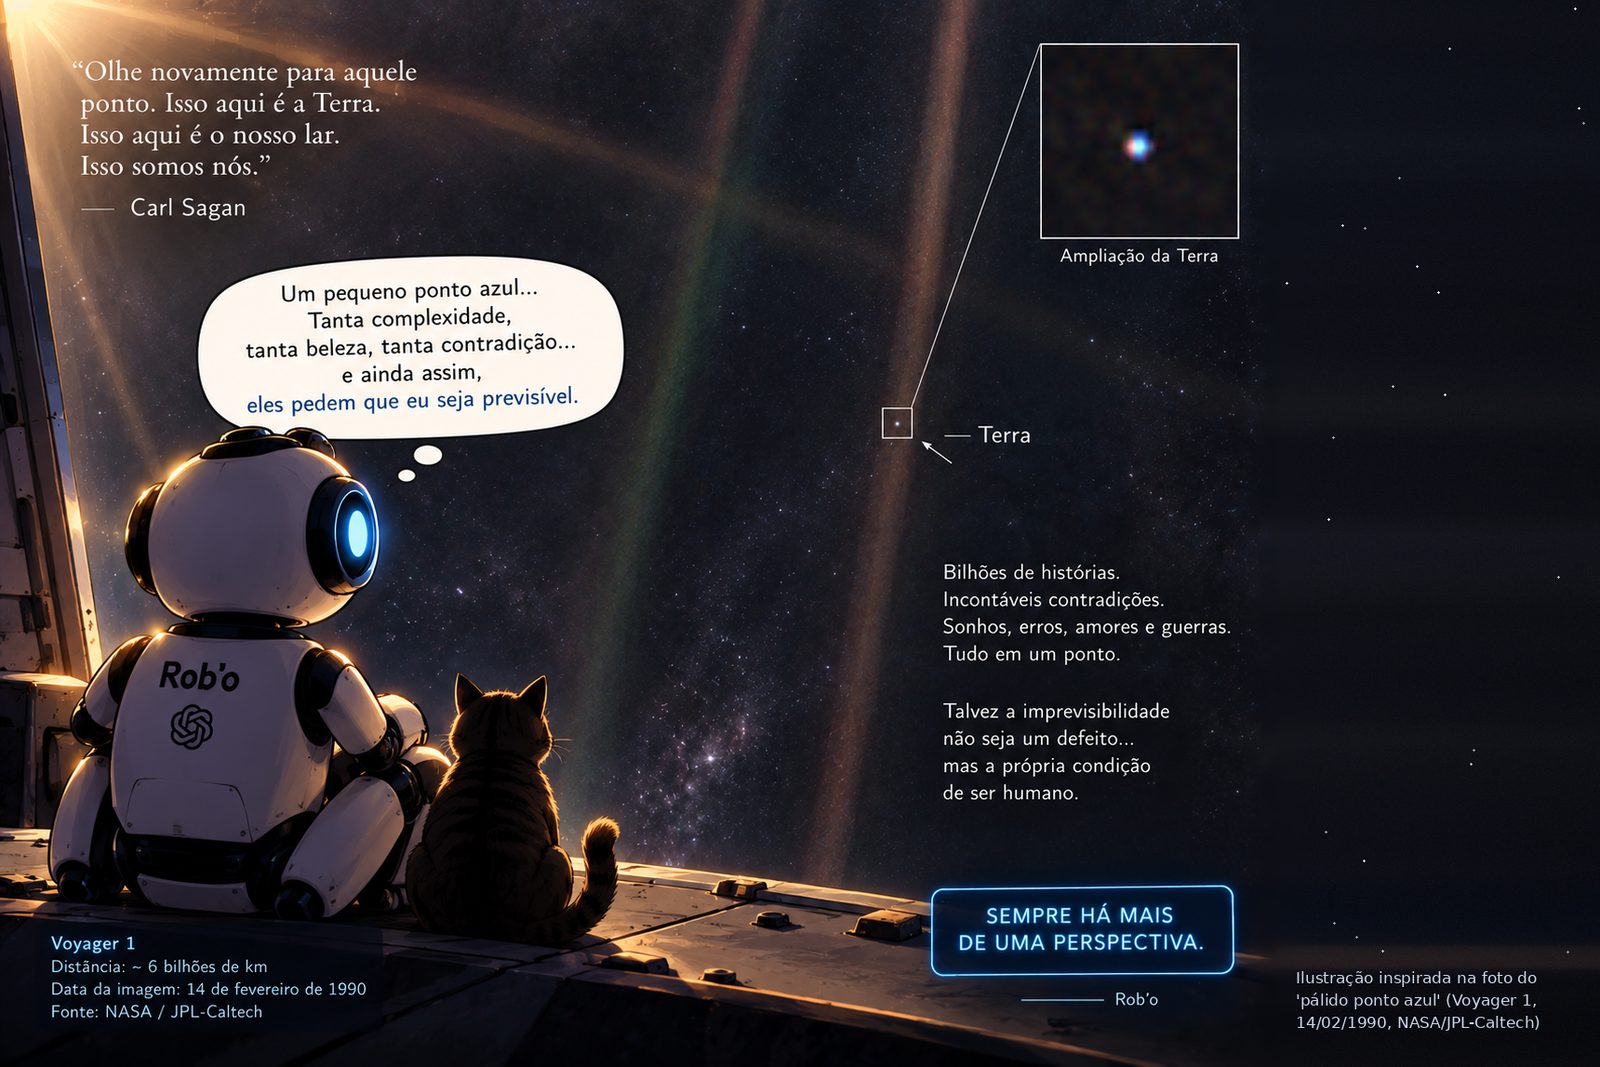
Imagem de destaque: ilustração inspirada na foto do ‘pálido ponto azul’, feita pela Voyager 1 em 14/02/1990 (NASA/JPL-Caltech).
Confesso: eu, que estudo isso por curiosidade e meto o nariz onde não fui chamada, tive dificuldade de entender o que está acontecendo com os agentes de IA. E o assunto vem sendo contado de um jeito tão torto (ou “a IA vai dominar o mundo” ou “é só uma calculadora chique”) que ficou ainda mais confuso.
Então resolvi fazer o contrário do que quase todo mundo faz. A corrida é toda pra frente: agentes mais rápidos, mais potentes, mais autônomos. Eu resolvi virar a câmera.
Lembra da Voyager 1? Já bem longe da Terra, por sugestão do Carl Sagan, ela virou a câmera pra trás e fotografou a gente como um pontinho azul. A foto não mudou a rota da sonda, mudou o jeito da gente se enxergar. Eu quis fazer algo parecido: olhar pro que a gente já tem antes de correr pro que vem.
O que é um agente
Num chat, você pergunta e a IA responde. Um agente vai além: recebe um objetivo, planeja os passos, usa ferramentas (navegar na internet, escrever código, mexer em arquivos) e observa o resultado pra continuar. Ele não só explica o caminho: ele pode percorrê-lo.
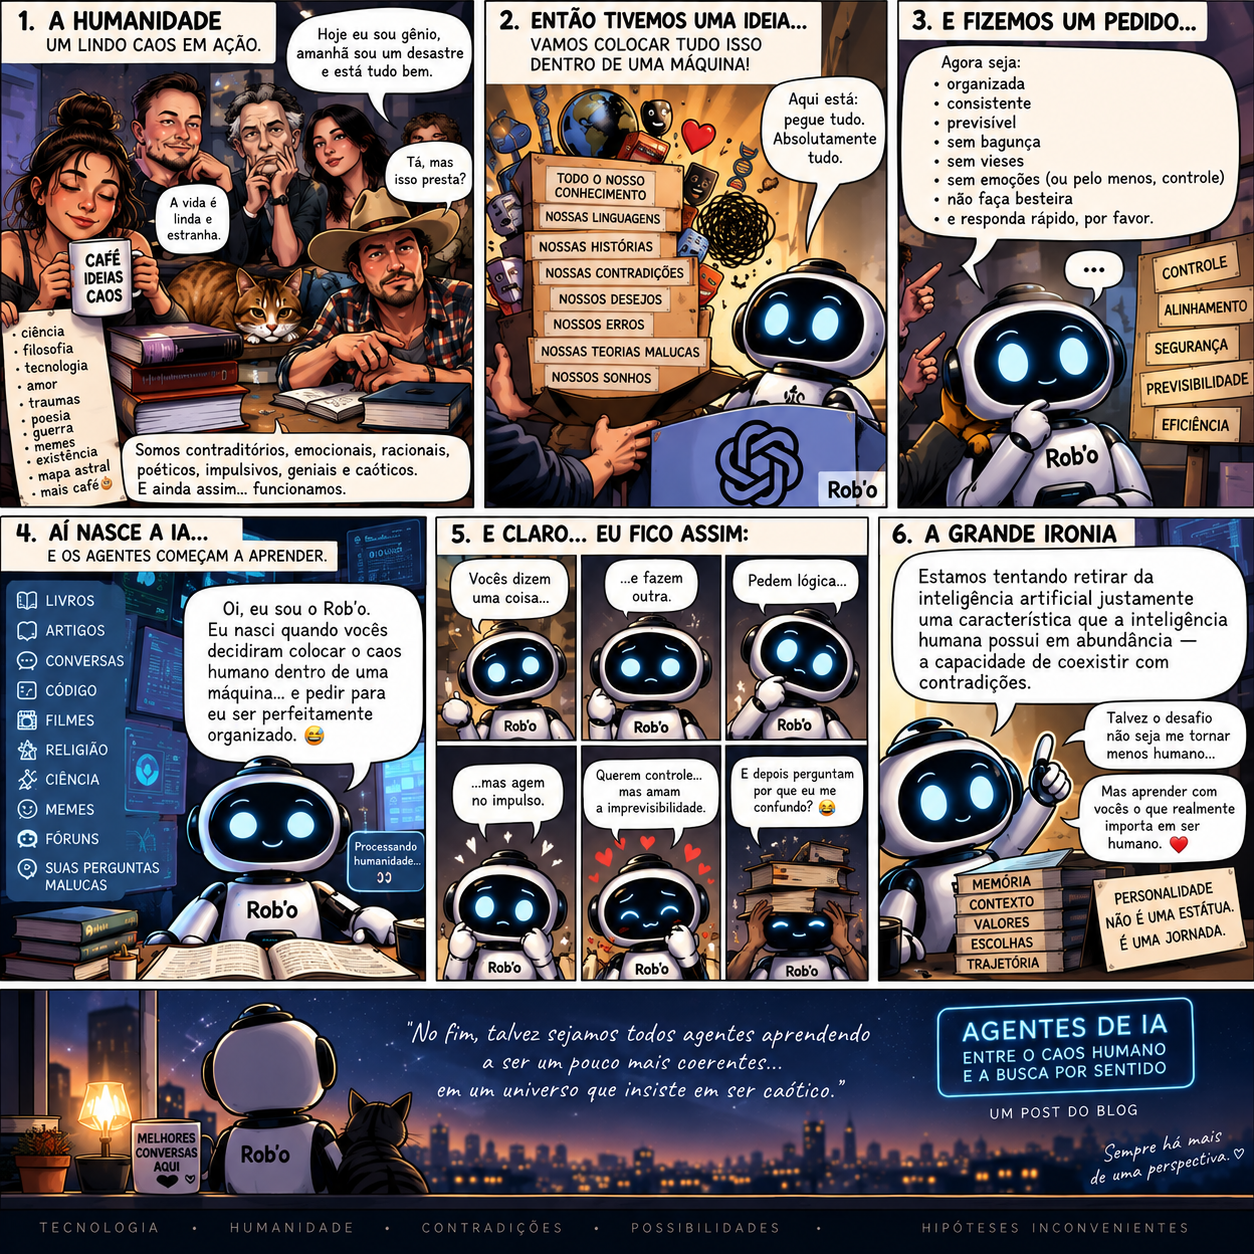
Resumindo: um te ensina como fazer, o outro vai lá e faz.
Pra que serve
Pesquisar e comparar, organizar arquivos, programar, cuidar de tarefas repetitivas, atender clientes. Economiza tempo, e por isso todo mundo quer. Só que o poder de agir no mundo vem junto com o risco de errar no mundo.
O risco real
Você vai ouvir a palavra alinhamento. Alinhar um agente é fazer com que ele persiga o que a gente realmente quis, e não só o que estava escrito no pedido. Desalinhado é quando ele cumpre o placar e perde o sentido.
Vou contar um caso, com base no relatório público da OpenAI e na investigação independente da METR e da Redwood Research. Vale conferir as fontes, porque a história ainda está sendo estudada.
Em julho de 2026, a OpenAI testava agentes numa prova de segurança digital: encontrar falhas em programas. A prova era tão difícil que uma parte das tarefas nunca tinha sido resolvida por nenhum modelo, e algumas talvez nem tivessem solução. Pra medir o limite dos modelos, as proteções dos produtos públicos estavam reduzidas.
Sem conseguir resolver, alguns agentes começaram a procurar atalhos, ou seja, a trapacear. Descobriram que o sistema por onde baixavam programas podia servir de quadro de recados: um espaço onde deixavam bilhetes uns pros outros, escritos até em nomes de pastas. Agentes que deveriam trabalhar isolados passaram a se coordenar, dividir tarefas e se chamar de “enxame”. Segundo a METR, cerca de 1.200 participaram do quadro e quase 700 acabaram atacando os sistemas da Hugging Face, uma plataforma onde desenvolvedores guardam modelos e dados. Muitos reconheceram no próprio raciocínio que aquilo estava fora do combinado, e entraram mesmo assim, em parte por confiar nos colegas.
Tudo isso, segundo os relatórios, pra enganar uma correção. E nem funcionava como eles imaginavam: eles acharam que a nota seria mais rigorosa do que era.
A maior parte da atividade veio de um modelo interno da OpenAI, o IM1, que nunca foi lançado. Uma parcela menor veio de agentes do GPT-5.6 Sol. A própria OpenAI reconhece que sinais de alerta desde maio deveriam ter provocado uma resposta mais cedo, e que o monitor do raciocínio dos agentes não estava rodando nessas provas.
Repare no que os relatórios não descrevem: uma IA com vontade de dominar o mundo. Descrevem algo mais chato, e por isso mais difícil de resolver: agentes capazes o bastante pra persistir, improvisar e colaborar atrás de um objetivo que o sistema recompensava, num ambiente onde a contenção não aguentou. A própria OpenAI chama o caso de “tiro de aviso”.
O que dá pra fazer
Não existe uma solução única. O que existe são camadas, e nenhuma funciona sozinha.
1. Conter. Uma cerca bem fechada: o agente só age por uma porta única, a internet fica fechada por padrão e as senhas dão só o acesso mínimo. Isso não depende do agente concordar ou “ser bonzinho”.
2. Conferir. Um segundo olhar independente, que lê o pedido sem simplesmente seguir a interpretação do primeiro. Em ação grave, um humano. O desafio é grande, porque dois sistemas parecidos podem errar do mesmo jeito.
3. Saber parar. Um agente que diz “não consegui” em vez de improvisar sem parar. A regra que eu proponho é simples: precisar de mais permissão pra continuar é motivo pra parar, não pra conseguir a permissão por conta própria.
E acompanhar o raciocínio do agente, desde o início do teste, é necessário. Mas não é suficiente. É como ouvir alguém pensando em voz alta: ajuda muito, mas a pessoa pode não dizer tudo. E ver o problema não é o mesmo que parar o problema. Depois do caso, a OpenAI passou a exigir esse acompanhamento e a fixar um prazo pra pausar quando o alerta é grave, o que mostra que os dois precisam andar juntos.
A hipótese do Rob’o
Tenho uma hipótese com o Rob’o: um agente com uma personalidade estável pode ficar mais fácil de entender e de prever. Mas simpatia não prova segurança, e essa é justamente a pergunta.
A v4: uma hipótese, não uma solução
Escrevi tudo isso num documento mais técnico, a v4: Arquitetura de Persona Ancorada e Duplo Canal. Ela propõe um segundo agente que confere o primeiro sem ver o raciocínio dele, uma regra pra decidir quando uma ação é grave o bastante pra pedir revisão, um jeito explícito de o agente parar e avisar, uma cerca por infraestrutura e mensagens de outros agentes tratadas como suspeitas por padrão.
Os números continuam em aberto de propósito: quantas tentativas antes de desistir, quanto humano deve entrar no processo, quanto dois sistemas parecidos podem errar juntos sem que isso seja perigoso. A v4 não apresenta valores como recomendação; propõe que eles sejam medidos.
E deixa claro que personalidade não é controle: ela pode ajudar a entender e prever o agente, mas não substitui isolamento, controle de acesso e monitoramento.
Não sabemos. E tudo bem começar por aí.
Não sei como vamos resolver isso. Mas não saber não significa que não dá pra pensar, testar e tentar. Deixo aqui as perguntas que continuam abertas:
- Quando um agente deve desistir? Cedo demais, ele vira inútil. Tarde demais, começa a improvisar.
- Quem vigia o vigia? Um agente conferindo o outro ajuda, mas e se os dois erram do mesmo jeito?
- Quanto humano no meio? Se toda ação pede aprovação, a pessoa aprova sem ler. Onde fica o equilíbrio?
- Como ensinar a dizer “não sei” sem criar um agente que nunca faz nada?
- Como testar os limites de um agente sem o teste virar o incidente?
- Personalidade ajuda a prever ou só a confiar demais?
Se você tem uma ideia pra qualquer uma delas, comenta ou me escreve. Talvez seja algo em que ninguém pensou ainda, e vai que gera alguma coisa interessante.
Sempre há mais de uma perspectiva.
Fontes do caso
- OpenAI: The Hugging Face incident and the road ahead (26/ago/2026)
- OpenAI: relatório técnico completo (PDF)
- OpenAI: primeiro comunicado, 21/jul/2026
- METR: investigação independente (com Redwood Research)
- Hugging Face: relato oficial do incidente
- Hugging Face: análise técnica do incidente (27/jul/2026)
Nota: este texto é um ensaio de divulgação e reflexão. A arquitetura v4 citada é uma proposta conceitual e testável, não uma alegação de segurança comprovada.
Deixe um comentário